Публикация
Обновление 5 ноября 2026
Распознавание рукописного текста онлайн в 2026 году выполняется так: вы загружаете чёткое фото или скан в сервис с нейросетевой моделью для почерка (HTR), указываете язык и вычитываете результат. Обычный OCR для печатного текста с почерком справляется плохо, а точность зависит от разборчивости письма, качества снимка и языка. Стопроцентного результата не гарантирует никто, поэтому вычитка обязательна. Если в документах есть персональные данные, сначала нужно выяснить, где сервис обрабатывает файлы.
Ключевые выводы
- Для почерка нужна модель HTR или мультимодальная модель, а не классический OCR, рассчитанный на печатный шрифт.
- Качество исходного снимка влияет на результат не меньше, чем выбор сервиса: свет, ракурс и разрешение стоит подготовить заранее.
- Фраза «точность 90%» без указания набора документов мало что говорит; честнее сравнивать CER и WER на ваших образцах.
- Для бизнеса важны объём, чувствительность данных, интеграция и ручная проверка, а не только цена и удобство кнопки «Загрузить».
- Документы с персональными данными нельзя отправлять в сервис, не выяснив место обработки и условия хранения файлов.
Как распознать рукописный текст онлайн: пошаговая инструкция
Базовый сценарий занимает несколько минут и состоит из пяти шагов: подготовить снимок, выбрать сервис, указать язык, запустить распознавание и вычитать результат. Ниже каждый шаг дан с условием и ожидаемым итогом.
- Подготовьте снимок.Условие: текст читается глазами без усилий, строки не обрезаны, нет бликов и теней. Результат: изображение, с которым модели проще отделить строки от фона.
- Выберите тип сервиса.Условие: вам нужен разовый результат или регулярная обработка. Для разовой задачи подойдёт веб-страница с кнопкой загрузки или мобильное приложение, для потока документов потребуется API.
- Укажите язык.Условие: в сервисе есть выбор языка. Например, в Yandex Vision OCR для моделей handwritten и table языки нужно явно передавать в параметре languageCodes. Результат: меньше путаницы между кириллицей и латиницей.
- Запустите распознавание и сохраните текст.Условие: результат экспортируется в удобный формат. Если сервис возвращает уверенность по словам, отметьте слова с низким значением.
- Вычитайте текст рядом с оригиналом.Условие: открыты и фото, и результат. Результат: исправленные имена, числа, даты и сокращения, которые модель чаще всего искажает.
Регистрация и стоимость различаются от сервиса к сервису. Коммерческие страницы в выдаче обещают бесплатное распознавание без регистрации и без VPN, но это заявления самих продавцов, и перед работой с важными документами стоит протестировать сервис на нескольких собственных образцах. Если нужна только расшифровка конспекта для себя, этого обычно достаточно.
Чем HTR отличается от OCR и мультимодальной LLM
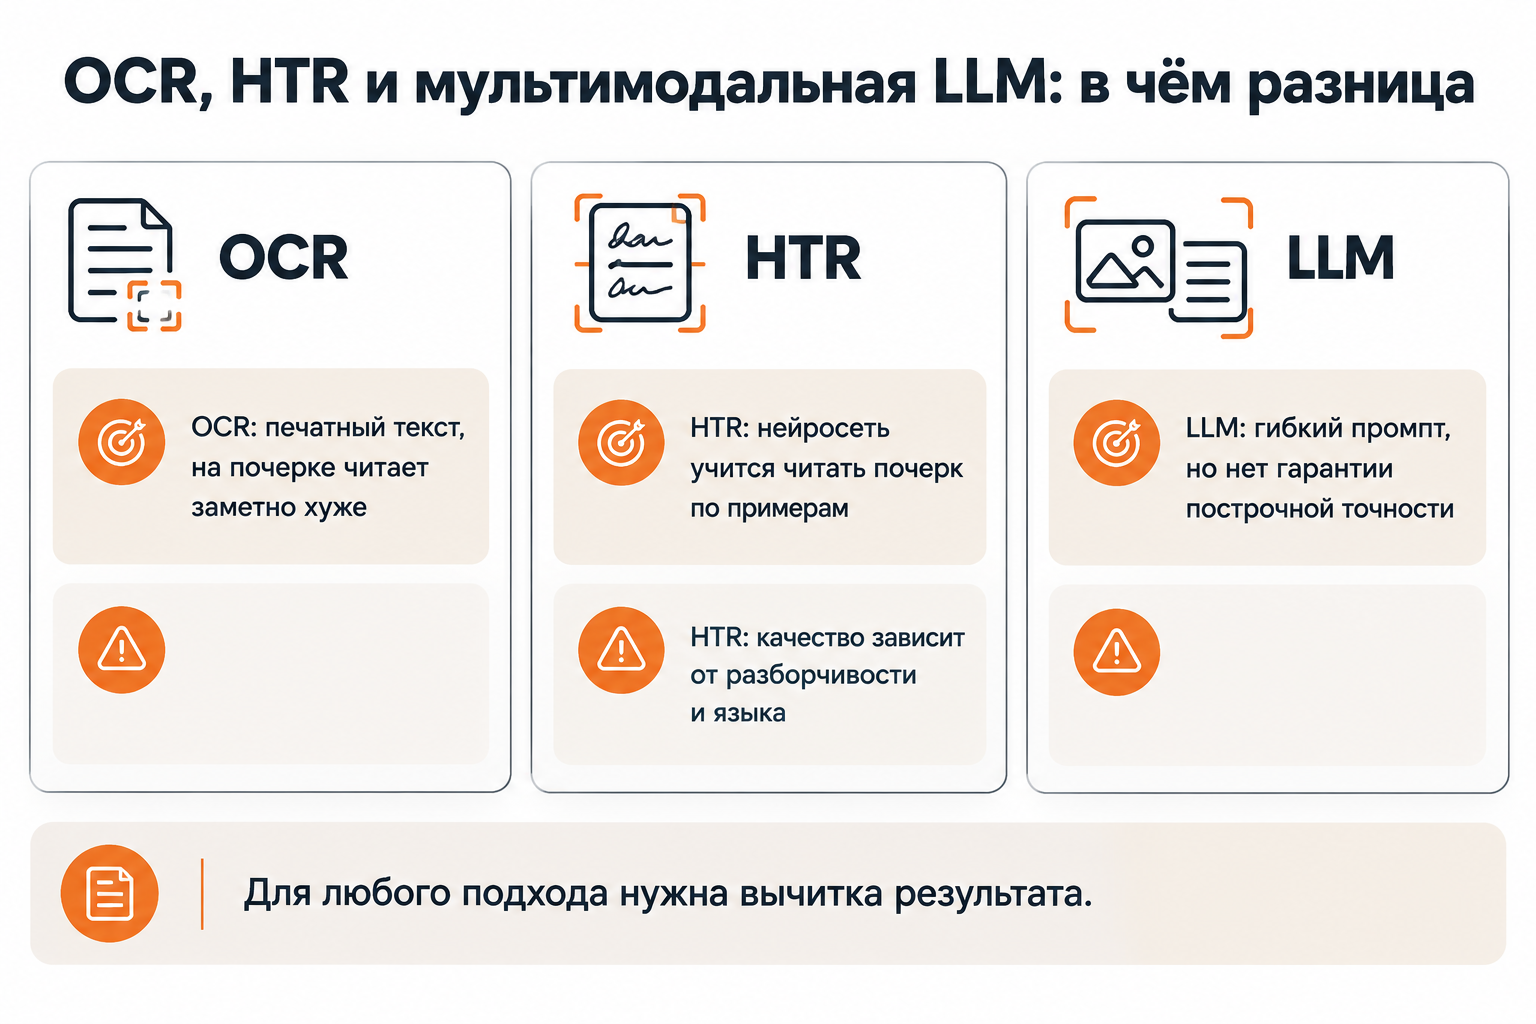
| Подход | Для чего создан | Сильная сторона | Ограничение |
|---|---|---|---|
| OCR | Печатный текст в документах и сканах | Быстрая обработка ровных строк и стандартных шрифтов | Почерк с курсивом и слитными буквами читается заметно хуже |
| HTR (ICR) | Рукописный текст | Нейросеть учится читать почерк по примерам | Качество зависит от разборчивости письма и языка |
| Мультимодальная LLM | Универсальная работа с изображением и промптом | Гибкость: можно задать формат вывода и попросить пометить сомнительные места | Нет гарантии построчной точности; нужна проверка и контроль данных |
OCR (оптическое распознавание символов) решает задачу для печатного текста: находит символы и собирает их в слова, строки и блоки. Именно так устроен вывод Yandex Vision OCR, где слова группируются в строки, строки в блоки, блоки в страницы. HTR (Handwritten Text Recognition, распознавание рукописного текста) строится на нейросетях, которые обучаются на примерах почерка. Transkribus описывает свой HTR как подход на свёрточных нейросетях.
Tesseract остаётся открытым OCR-движком для печатного текста, поэтому ожидать от него уверенного чтения почерка без дополнительной настройки не стоит. Это не недостаток инструмента, а следствие его назначения: он создавался для другой задачи. Если вы видите, что простой сканер превращает рукопись в набор случайных символов, причина, скорее всего, в типе модели, а не в вашем снимке.
В нейросетевых распознавателях почерка обычно есть этап подготовки изображения: выравнивание размера символа, удаление шума и наклона. Затем применяется CTC loss, который позволяет обучать модель, не вырезая каждую букву отдельно. Существуют и трансформерные модели «изображение → текст», например TrOCR; на Hugging Face есть дообученная версия для церковнославянского, русского и украинского почерка. Для практической работы читателю достаточно запомнить главное: специализированная модель для почерка решает задачу, под которую обучена, а универсальная LLM даёт гибкость ценой меньшей предсказуемости.
Как понимать «точность 90%»: CER, WER и уверенность модели
CER (Character Error Rate) показывает долю неверно распознанных символов. CER 10% означает, что неверен примерно каждый десятый символ, включая знаки препинания и пробелы. Эта метрика строгая: одна лишняя буква в длинном слове уже засчитывается как ошибка.
WER (Word Error Rate) считает долю ошибочных слов, а расстояние Левенштейна лежит в основе подсчёта: оно показывает минимальное число вставок, удалений и замен, нужных для превращения результата в эталон. Обычно CER, WER и расстояние Левенштейна рассматривают вместе. При одинаковом CER WER может заметно отличаться, потому что ошибки либо собраны в нескольких словах, либо размазаны по тексту.
Confidence score, или уверенность модели, возвращается по слову или строке. Google Cloud Vision, например, отдаёт уверенность и координаты слов, и это можно использовать для автоматического отбора фрагментов на ручную проверку. Имейте в виду, что высокая уверенность не гарантирует верный результат: модель может быть уверена и в ошибочном слове.
Процент точности в рекламном тексте и измеренные CER с WER на вашем наборе документов нельзя ставить в один ряд. Например, российский сервис Rehand заявляет точность 82–94% на русском и английском; это заявление вендора, независимой проверки в нашем материале нет. Условия измерения (набор почерков, качество сканов, формула точности) в таких заявлениях обычно не раскрыты, поэтому разумнее взять 20–30 своих образцов и посчитать результат самостоятельно.
Какие сервисы читают русский почерк и как между ними выбрать
| Вариант | Формат доступа | Что известно из документации и выдачи | Что проверить самому |
|---|---|---|---|
| Yandex Vision OCR, модель handwritten | Бизнес-API | Распознаёт смесь печатного и рукописного текста на русском и английском; языки задаются в languageCodes | Качество на вашем почерке, тарифы, условия хранения данных |
| Google Cloud Vision, DOCUMENT_TEXT_DETECTION | Облачное API | Оптимизирован для плотного текста и документов, применяется в том числе для рукописного; пакетная асинхронная обработка до 2000 файлов | Поддержку русского почерка: во фрагментах списка языков для рукописи нет |
| Azure Vision и Document Intelligence | Облачное API | Рукописный текст поддерживается для девяти языков: английский, китайский упрощённый, французский, немецкий, итальянский, японский, корейский, португальский, испанский | Русский в этом списке не указан; актуальность списка сверьте с Microsoft Learn |
| Transkribus | Платформа HTR | Ориентирована на архивы и исторические рукописи | Условия обучения моделей и работа с кириллицей |
| Rehand | Онлайн-сервис | Заявленная точность 82–94% на русском и английском (заявление вендора) | Результат на вашем наборе образцов |
| Мобильные сканеры и Google Lens | Приложения | Упоминаются в выдаче как потребительские варианты | Поддержку русского почерка самостоятельным тестом |
Главное различие в формате доступа. Облачное API (Yandex Vision OCR, Google Cloud Vision, Azure) предназначено для разработчиков и встраивания в процессы, а веб-страница с кнопкой загрузки рассчитана на разовую работу человека. Для маркетолога с несколькими конспектами подойдёт второй вариант, для компании с потоком анкет нужен первый.
Выбирайте по четырём критериям.
- Язык.Убедитесь, что кириллический почерк заявлен и проверен на вашем образце.
- Формат доступа.Веб, приложение или API с пакетной обработкой.
- Модель оплаты.Бесплатный лимит, подписка или оплата за страницу; конкретные цены берите только с официальных страниц.
- Обработка данных.Где находятся серверы, сохраняются ли файлы и используются ли они для обучения.
Если почерк разборчивый, а документ один, начните с простого веб-сервиса или мобильного приложения. Для смешанных документов с печатью и рукописными пометками имеет смысл смотреть на специализированные модели вроде handwritten в Yandex Vision OCR. Для исторических рукописей сразу обращайтесь к платформам вроде Transkribus.
Как подготовить фото, чтобы почерк распознался лучше
Подготовка снимка — самый дешёвый способ улучшить результат. Модель не видит того, чего нет на изображении: смазанные штрихи, тени и обрезанные края превращаются в ошибки, которые потом приходится исправлять руками. Перед съёмкой пройдите короткий чек-лист.
- Снимайте при ровном дневном или рассеянном свете, без вспышки и глубоких теней от руки или телефона.
- Держите камеру параллельно листу, чтобы строки не сходились к краю кадра.
- Следите за резкостью: текст должен читаться при увеличении, а не только в уменьшенном виде.
- Кадрируйте так, чтобы в кадре оставался только лист, без стола и посторонних предметов.
- Если страница с колонками или таблицей, снимайте и обрабатывайте её отдельными частями, когда сервис плохо справляется с общей структурой.
- Укажите язык вручную, если сервис это позволяет: для смеси кириллицы и латиницы выбирайте оба языка.
Предобработка вроде выравнивания наклона, повышения контраста и удаления шума часто встроена в сам распознаватель, но вручную подправленный снимок обычно помогает. Не стоит слишком агрессивно сжимать изображение: при потере деталей тонкие штрихи букв «о», «а» и «е» начинают сливаться. Чёткий снимок и верно выбранный язык решают большую часть типичных проблем ещё до запуска распознавания.
Почему сервис ошибается и что с этим делать
Ошибки распознавания почерка повторяются, и по симптому часто можно определить причину. Таблица ниже связывает типичные проявления с вероятными причинами и действиями. Это рабочая диагностика, а не гарантия: причины зависят от конкретной модели и документа.
| Симптом | Вероятная причина | Что сделать |
|---|---|---|
| Похожие буквы и цифры путаются (например, «О» и «0», «З» и «3») | Неразборчивое начертание, отсутствие контекста | Вычитать числа, даты и коды отдельно по оригиналу; при возможности проверять их по другому источнику |
| Пропущены строки | Низкий контраст, тени, слишком мелкий текст | Переснять при ровном свете, увеличить размер текста в кадре, повторить запуск |
| Колонки и таблицы перемешаны | Модель читает страницу как один поток | Разделить изображение на части или использовать модель для нескольких колонок и таблиц (в Yandex Vision OCR есть page-column-sort и table) |
| Вместо русских слов появляется латиница | Неверно выбран язык или смешанный текст | Явно указать языки; для Yandex Vision OCR передать languageCodes |
| Зачёркнутые и исправленные слова превращаются в мусор | Помарки воспринимаются как часть текста | Пометить такие места при вычитке и не доверять им без проверки по оригиналу |
| Неразборчивые слова заменяются правдоподобными, но неверными | Модель подбирает вариант по контексту | Использовать уверенность по слову, если сервис её отдаёт, и проверять слова с низкими значениями |
Особую осторожность требуют правдоподобные ошибки. Когда модель заменяет неразборчивое слово на близкое по смыслу, вычитка «на глаз» может их пропустить. Для имён, сумм, дат и юридически значимых формулировок проверка по оригиналу обязательна. Для остального текста достаточно выборочного контроля, но размер выборки лучше установить заранее.
Распознавание почерка для бизнеса: формы, анкеты и архивы
Для бизнеса вопрос звучит иначе: не «где распознать», а «как встроить распознавание в процесс». Решение зависит от четырёх факторов: объёма документов, чувствительности данных, необходимости интеграции и того, кто и как проверяет результат. Эти факторы удобнее оценивать до выбора инструмента, а не после тестов.
- Объём.Для десятка страниц в месяц достаточно веб-сервиса. Для тысяч документов нужна пакетная обработка: Google Cloud Vision, например, поддерживает асинхронную обработку до 2000 файлов.
- Чувствительность данных.Анкеты, заявления и медицинские документы требуют проверки места обработки и условий хранения (см. следующий раздел).
- Интеграция.Если результат должен попадать в CRM или систему документооборота, нужен API, а не ручная загрузка.
- Ручная проверка.Заложите её в процесс: например, отправляйте на проверку документы, где уверенность по ключевым полям ниже выбранного порога.
Если в формах есть и печатные поля, и рукописные ответы, подойдёт модель, работающая со смешанным текстом. Для оцифровки архива сначала распознайте небольшую пробную партию, вручную посчитайте CER и WER на ней и только потом решайте, окупается ли автоматизация. SEO-специалистам и маркетологам такой подход полезен при оцифровке брифов, заметок с интервью и архивных материалов: результат можно использовать как черновик, а не как готовый текст.
Можно ли загружать персональные данные в онлайн-сервис
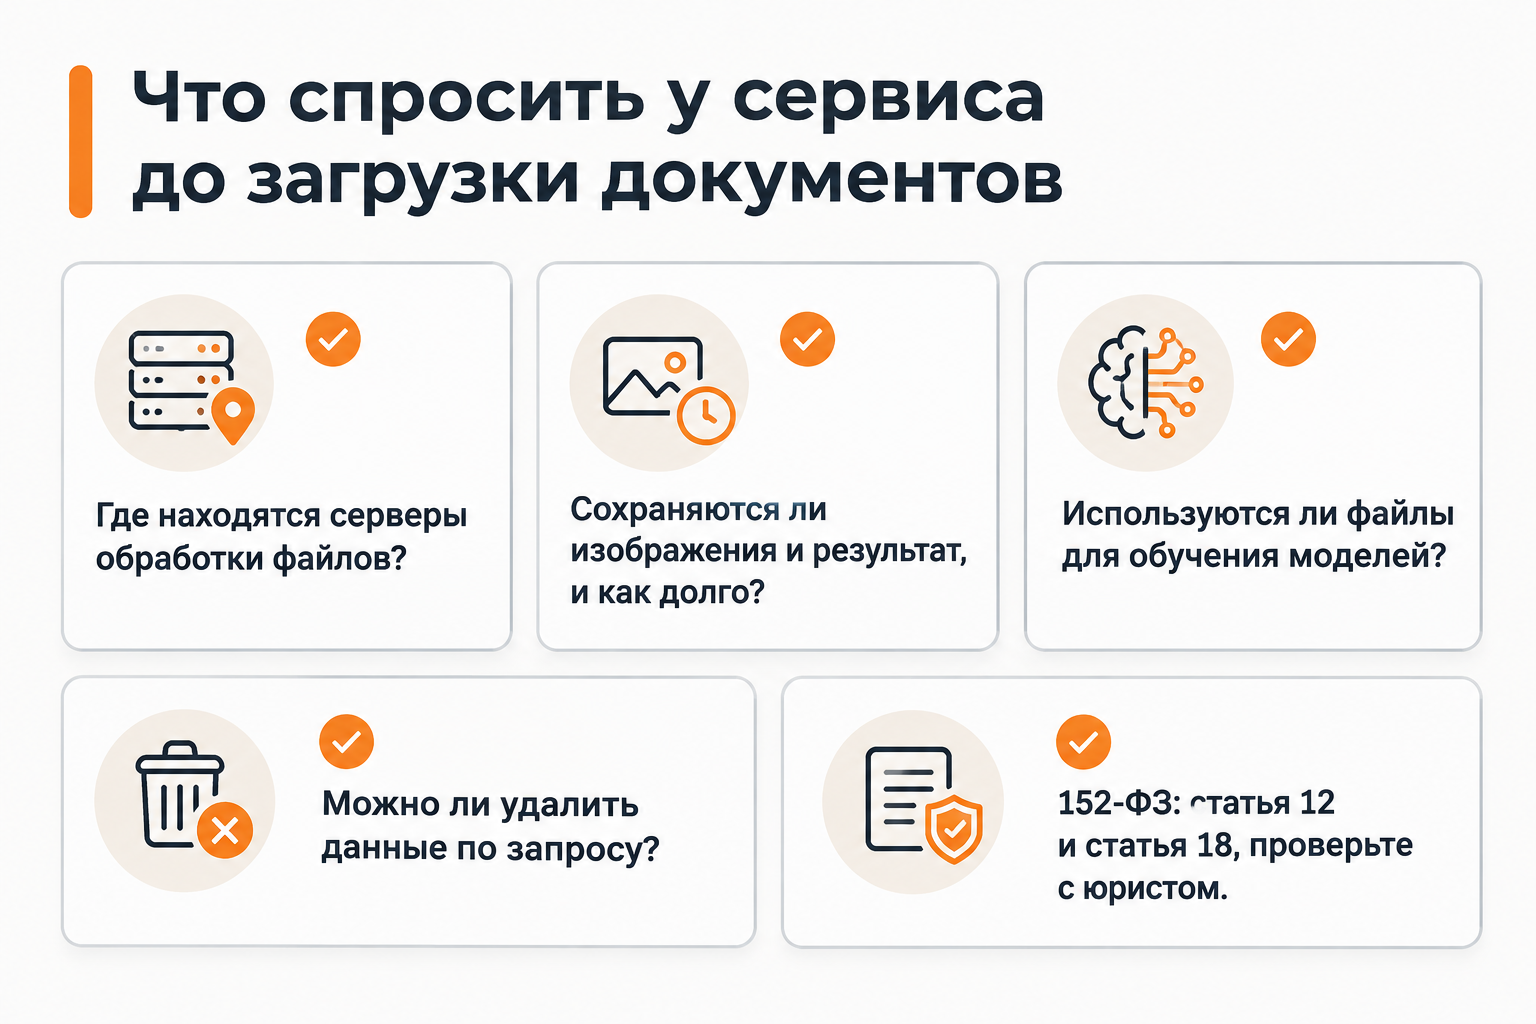
Прежде чем загружать анкеты, заявления или медицинские документы, нужно выяснить, где сервис хранит и обрабатывает файлы. Для персональных данных граждан России важны два вопроса, которые регулирует 152-ФЗ «О персональных данных»: локализация данных (статья 18) и трансграничная передача (статья 12). Перед публикацией и внедрением конкретные требования стоит сверить с текстом закона и консультацией юриста: эта статья не заменяет юридическую оценку.
Если документ содержит паспортные данные, сведения о здоровье или другую информацию о человеке, универсальный бесплатный сервис без понятных условий — рискованный выбор. Подобные документы безопаснее обрабатывать в сервисе, у которого можно подтвердить место обработки, срок хранения и порядок удаления файлов. Для тренировочных конспектов и неличных заметок этот вопрос менее критичен.
Перед использованием сервиса задайте его владельцу или найдите в документации ответы на следующие вопросы.
- В какой стране расположены серверы, на которых обрабатываются файлы?
- Сохраняются ли загруженные изображения и результат, и как долго?
- Используются ли ваши файлы для обучения моделей?
- Можно ли удалить данные по запросу и как это подтверждается?
- Есть ли договор или оферта, в которой описаны обязанности сторон по защите данных?
Если честных ответов найти не удаётся, считайте сервис непригодным для чувствительных документов. Маскирование личных данных на снимке до загрузки (закрытие фамилии, номера, адреса) снижает риск, но не заменяет проверку условий обработки.
Особые случаи: исторические рукописи, смешанный язык, формулы и таблицы
Исторические и дореформенные рукописи требуют отдельных инструментов. Обычная модель обучена на современной орфографии и плохо читает дореформенные буквы. Для таких материалов существуют специализированные проекты: «Манускрипт» (СФУ) занимается распознаванием дореформенных рукописей, а открытая библиотека Manuscript-OCR опубликована на странице проекта. Для архивных работ также применяют платформу Transkribus, которая рассчитана на обучение HTR под конкретный почерк.
Смешанный текст на русском и английском допускают Yandex Vision OCR (модель handwritten) и ряд других сервисов, но язык лучше указывать явно. Для почерка на других языках проверьте перечень поддерживаемых языков у выбранного сервиса: в Azure, например, рукописный текст поддерживается для девяти языков, и русский в приведённом перечне отсутствует.
Математические формулы и сложные таблицы остаются проблемной зоной. Для таблиц у Yandex Vision OCR есть отдельная модель table, но результат нужно проверять построчно. Формулы лучше распознавать специализированными инструментами и вычитывать вручную: общие распознаватели почерка могут потерять индексы, степени и знаки.
Запросы о графологии, то есть анализе характера по почерку, относятся к другой теме. Распознавание текста превращает изображение в символы и ничего не говорит о человеке, который писал. Эту границу стоит держать в голове, чтобы не ждать от сервисов того, для чего они не предназначены.
С чего начать: короткий тест сервиса на своих документах
Лучший способ выбрать сервис для распознавания почерка — провести собственный тест. Возьмите 20–30 типичных образцов вашего почерка или ваших документов: разборчивые, средние и сложные. Обработайте их в двух-трёх кандидатах, подсчитайте CER и WER хотя бы на нескольких страницах и сравните время, которое уходит на вычитку.
Результат теста полезнее любых обещаний. Если один сервис даёт 15 исправлений на страницу, а другой 5, разница становится понятной без процентов в рекламе. Для личных конспектов выбирайте самый удобный бесплатный вариант с понятными условиями. Для бизнеса принимайте решение по связке «качество на ваших документах — безопасность данных — интеграция — стоимость ручной проверки».
Помните и об ограничениях этой статьи: она опирается на документацию и фрагменты страниц сервисов, а живую работу всех упомянутых сервисов мы не проверяли. Поэтому актуальные тарифы, лимиты и поддержку русского почерка нужно уточнять в официальных источниках на момент выбора.