

Публикация
Обновление 13 октября 2026
Автономные ИИ-агенты перестали быть экспериментальной технологией – сегодня они обрабатывают входящие заявки, записывают клиентов, отвечают на вопросы по базе знаний и синхронизируют данные между системами без участия человека. Разрыв между компаниями, которые уже внедрили подобные решения, и теми, кто только присматривается, измеряется не месяцами, а конкурентными позициями.
В этом руководстве разобрана полная цепочка: от понимания того, чем агент принципиально отличается от чат-бота или ChatGPT, до выбора архитектуры, пошагового проектирования, развёртывания в продакшене и контроля безопасности. Материал будет полезен как техническим специалистам, так и бизнес-руководителям, которые планируют внедрить технологию и хотят понимать, что именно они запускают.
Суть и отличия AI-агентов простыми словами
Прежде чем погружаться в технические детали, важно разобраться в базовых понятиях. Рынок переполнен терминами: чат-бот, GPT-обёртка, автоматизация, агент. Разница между ними – не маркетинговая, а архитектурная.
Что такое ИИ-агент и его ценность для современного бизнеса
Автономный интеллектуальный агент – это программная система, способная самостоятельно воспринимать контекст, ставить подзадачи и последовательно выполнять их без пошагового участия человека. Ключевое слово здесь – «автономно». В отличие от скриптового бота, такая система не ждёт следующей команды: она сама определяет, что делать дальше.
Ценность для бизнеса измеряется в конкретных показателях:
Оптимизация фонда оплаты труда (ФОТ)– агент обрабатывает типовые обращения клиентов круглосуточно без перерывов и больничных.
Скорость квалификации лидов– входящий запрос в мессенджере обрабатывается за секунды, а не минуты.
Минимизация человеческого фактора– стандартизированные ответы исключают ошибки, вызванные усталостью или настроением сотрудника.
По данным McKinsey Digital, компании, внедрившие ИИ в клиентские процессы, сокращают операционные затраты на обслуживание на 20–40% в течение первых 12 месяцев эксплуатации. Это не абстракция – это измеримый результат, достижимый при грамотном проектировании системы.
Отличия AI-агента от классического чат-бота и стандартных LLM
Путаница между этими тремя категориями – одна из самых распространённых ошибок при выборе инструмента автоматизации.
Характеристика | Классический чат-бот | Базовая LLM (ChatGPT) | AI-агент |
Логика работы | Жёсткий скрипт (if-then) | Генерация ответа на один промпт | Планирование + действие + корректировка |
Память | Отсутствует | Только текущий контекст сессии | Кратко- и долгосрочная |
Инструменты | Не использует | Ограниченно (плагины) | Вызов внешних API, БД, сервисов |
Автономность | Нет | Минимальная | Высокая |
Применимость | FAQ, простые сценарии | Генерация контента, Q&A | Сложные бизнес-процессы |
ChatGPT – это интерфейс к предобученной языковой модели. Он отвечает на вопрос, но не помнит вас через час и не может самостоятельно записать клиента в CRM. ИИ-агент делает именно это: получает задачу, обращается к нужным системам, выполняет цепочку шагов и возвращает результат.
Принцип работы автономных интеллектуальных систем
Цикл работы агента состоит из четырёх повторяющихся фаз:
Perception (Восприятие)– система получает входные данные: сообщение пользователя, результат предыдущего шага, данные из внешнего сервиса.
Reasoning (Планирование)– языковая модель анализирует контекст и формирует план действий: «сначала проверю слоты в расписании, затем запрошу данные клиента».
Action (Действие)– агент выбирает и вызывает нужный инструмент: поиск, SQL-запрос, API-вызов.
Observation (Корректировка)– система получает результат и при необходимости пересматривает план.
Этот цикл повторяется до достижения цели или исчерпания лимита итераций.
Архитектура и основные компоненты автономного ИИ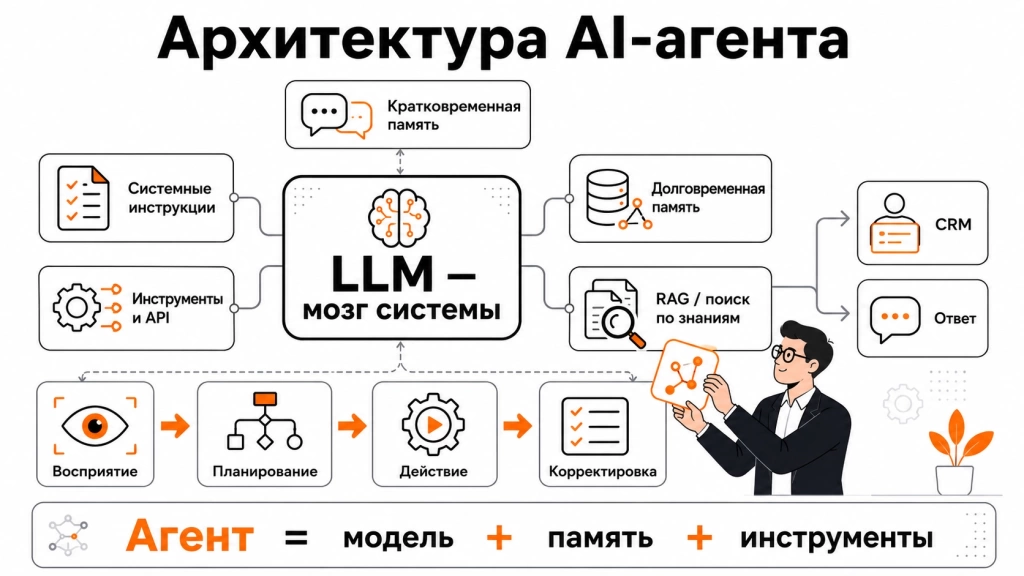
Понять, как устроен агент изнутри, – значит научиться его проектировать, а не просто настраивать. Архитектура системы определяет её возможности, стоимость эксплуатации и устойчивость к нестандартным сценариям.
Большая языковая модель как центральный мозг системы
Языковая модель – это вычислительное ядро, которое интерпретирует команды, декомпозирует задачи и генерирует ответы. Выбор конкретной модели напрямую влияет на качество работы и стоимость токенов.
Актуальные варианты:
GPT-5.5 (OpenAI)– сильный выбор для сложных рассуждений, мультимодальных задач и высоконагруженных enterprise-сценариев.
Claude 4.6 Sonnet (Anthropic)– конкурентоспособен по качеству вывода и заметно дешевле флагманов OpenAI при сопоставимом качестве для большинства бизнес-задач.
Llama 4 (Meta)– open-source вариант на базе архитектуры Mixture-of-Experts (MoE) для компаний, которым критично развернуть модель на собственных серверах и не передавать данные третьим сторонам.
Выбор зависит от трёх факторов: бюджета на токены, требований к конфиденциальности и сложности задач агента.
Системные инструкции и слой промпт-инжиниринга
Системный промпт – это конституция агента. Именно он задаёт роль, ограничения, тональность и правила принятия решений. Плохо написанная инструкция – главная причина непредсказуемого поведения системы в продакшене.
Пример для агента логистической компании:
«Ты – ассистент службы доставки компании X. Твоя задача – отслеживать статусы заказов, консультировать клиентов по срокам и инициировать процедуру компенсации при задержке более 48 часов. Никогда не сообщай приблизительные данные – только факты из базы. Если информация недоступна, честно сообщи об этом и предложи связаться с оператором.»
Хорошая инструкция содержит: роль, контекст бизнеса, допустимые действия, запрещённые темы и формат ответа. Промпт-инжиниринг – не творчество, а системная работа с итеративным тестированием.
Инструменты, функции и интеграция внешних API
Tool Calling (вызов функций) – механизм, благодаря которому агент перестаёт быть текстовым генератором и становится действующей системой. Языковая модель анализирует контекст и принимает решение: «здесь нужен не ответ, а действие».
Типичные инструменты в составе бизнес-агента:
Веб-поиск (актуальные данные)
SQL-запросы к внутренним базам данных
Вызовы REST API сторонних сервисов (CRM, складские системы)
Калькулятор (точные вычисления без LLM-галлюцинаций)
Отправка уведомлений через вебхуки
Каждый инструмент описывается JSON-схемой: название, параметры, тип данных, описание. Модель читает эти схемы и формирует валидный вызов в нужный момент.
Системы кратковременной и долговременной памяти
Память – то, что отличает агента от одноразового промпта. Архитектура памяти строится на двух уровнях.
Short-term (кратковременная):контекст текущего диалога, умещающийся в контекстном окне модели. Этот контекст ограничен по объёму (обычно 8K–200K токенов в зависимости от модели).
Long-term (долговременная):хранение истории между сессиями. Реализуется через векторные базы данных – Pinecone, Chroma, Qdrant. Текст преобразуется в числовые эмбеддинги, которые позволяют искать семантически близкие фрагменты, а не просто по ключевым словам.
Практический пример: клиент возвращается через две недели, и агент «помнит», что он предпочитает доставку утром и уже жаловался на конкретного курьера. Это становится возможным именно через векторное хранилище.
Выбор методологии разработки: код, low-code или no-code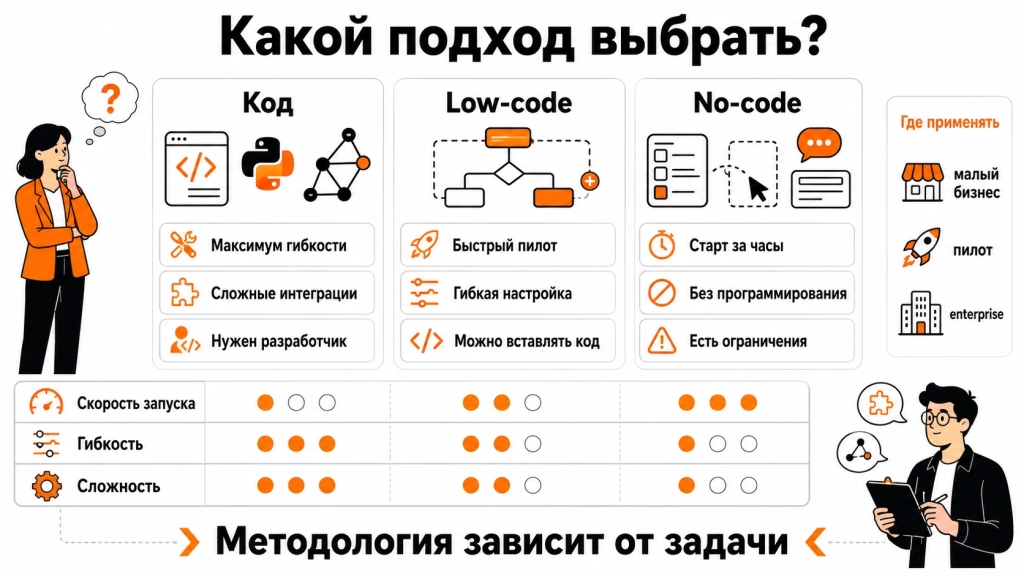
Выбор подхода к реализации – стратегическое решение, которое влияет на бюджет, скорость запуска и гибкость системы. Универсального ответа нет: всё зависит от задачи, команды и горизонта развития проекта.
Разработка с нуля на Python и специализированных фреймворках
Full-code подход дает максимальный контроль над поведением агента и неограниченные возможности интеграции. Ключевые библиотеки экосистемы:
LangChain– универсальный фреймворк для построения цепочек вызовов модели и инструментов.
LangGraph– расширение LangChain для агентов с граф-архитектурой, где шаги – узлы, переходы – рёбра. Идеально для сложных ветвящихся сценариев.
CrewAI– фреймворк для мультиагентных систем, где несколько агентов работают в команде с разными ролями.
AutoGen (Microsoft)– ориентирован на диалог между агентами и решение исследовательских задач.
Плюсы:полная кастомизация, масштабируемость, возможность оптимизации стоимости токенов.
Минусы:требуется Python-разработчик с опытом работы с LLM, цикл разработки MVP – от 2 до 6 недель.
Использование low-code платформ для гибкой настройки
Компромиссный вариант для команд, где есть технически грамотный специалист, но нет выделенного разработчика. Платформы типа Flowise, Dify или Make позволяют собирать логику агента визуально – перетаскиванием блоков – с возможностью вставки кастомного кода в критических узлах.
Это подходит для стартапов с ограниченным бюджетом, пилотных проектов перед полноценной разработкой и агентов с типовыми интеграциями (Telegram + CRM + базовый RAG).
Создание в no-code конструкторах для быстрого старта
Инструменты класса BotHelp или аналогичные no-code экосистемы позволяют создать агента за несколько часов без единой строки кода. Маркетолог или продуктовый менеджер самостоятельно настраивает сценарии, подключает мессенджеры и запускает автоответы.
Ограничения очевидны: сложные интеграции, нестандартная логика и масштабирование быстро упираются в потолок платформы. Но для малого бизнеса с типовыми задачами (запись клиентов, ответы на FAQ, сбор контактов) – это вполне рабочее решение с быстрой окупаемостью.
Пошаговый процесс проектирования и разработки AI-агента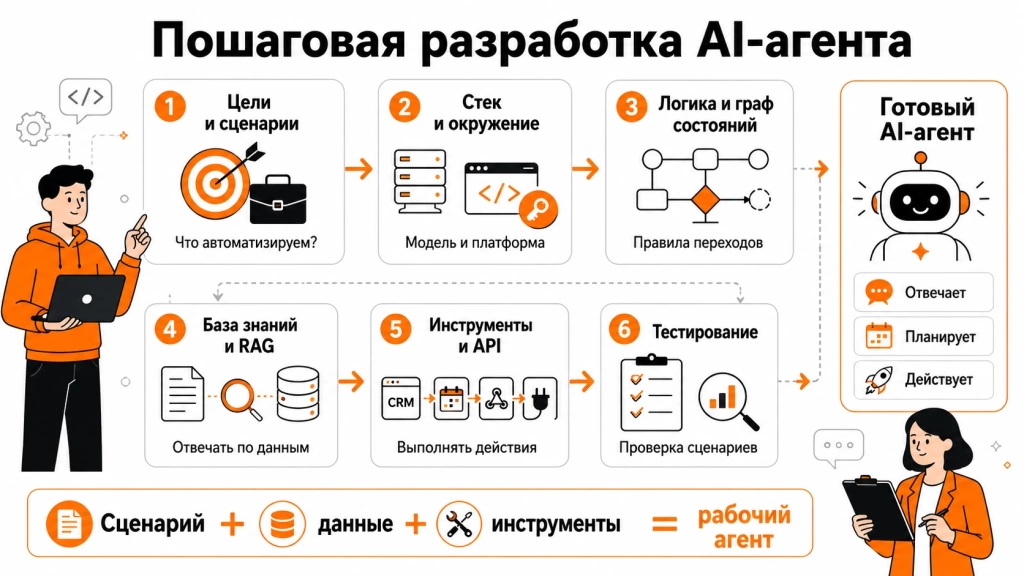
Это ключевой раздел для тех, кто переходит от теории к практике. Разберём каждый этап – от формулировки задачи до финального тестирования.
Этап 1. Определение целей, сценариев и границ применения
Самая распространённая ошибка – начать с выбора технологии, а не с описания задачи. Правильный старт – составление технического задания с ответами на вопросы:
Какой конкретный сценарий автоматизируется? (узкий use case, не «умный помощник»)
Какие данные будут на входе и какой результат ожидается на выходе?
По каким метрикам вы поймёте, что система работает корректно?
Хороший ТЗ-пример: «Агент принимает входящие сообщения в Telegram, квалифицирует лида по 3 критериям, проверяет свободные слоты в Битрикс24 и подтверждает запись. Метрика успеха: конверсия из диалога в запись ≥ 65%.»
Этап 2. Подготовка окружения и выбор технологического стека
Для Python-разработки: создайте виртуальное окружение (python -m venv venv), получите API-ключи OpenAI или Anthropic, установите базовые библиотеки (langchain,openai,python-dotenv).
Для no-code: зарегистрируйтесь на выбранной платформе, подключите каналы коммуникации (Telegram Bot API, WhatsApp Business), настройте интеграцию с CRM через webhook или встроенный коннектор.
Этап 3. Настройка логики, графа состояний и рабочих процессов
LangGraph реализует архитектуру, в которой каждый шаг агента – это узел графа с чётко определёнными входами и выходами. Переходы между узлами описываются условиями: «если пользователь хочет записаться → перейти к проверке слотов; если задаёт вопрос → перейти к поиску по базе знаний».
Граф состояний решает проблему, с которой сталкиваются все линейные цепочки: непредсказуемые ответы пользователя. Вместо жёсткого скрипта вы получаете систему с явными состояниями и правилами переходов.
Этап 4. Подключение базы знаний и механизмов поиска RAG
RAG (Retrieval-Augmented Generation) – технология, которая позволяет агенту отвечать на вопросы на основе корпоративных документов, а не генерировать ответы «из головы».
Процесс внедрения:
Загружаете документы (PDF, DOCX, Excel, регламенты).
Разбиваете текст на чанки (обычно 500–1000 токенов с перекрытием).
Преобразуете чанки в векторные эмбеддинги через модель (text-embedding-3-small или аналог).
Сохраняете в векторную БД (Qdrant, Chroma, Pinecone).
При каждом запросе агент ищет семантически релевантные фрагменты и передаёт их в контекст модели.
Результат: агент отвечает фактами из ваших документов, а не придумывает информацию.
Этап 5. Настройка инструментов взаимодействия с внешними сервисами
Каждый инструмент описывается JSON-схемой, которую читает языковая модель. Пример схемы для инструмента проверки слотов в расписании:
{
"name":"check_available_slots",
"description":"Проверяет свободные временные слоты в CRM",
"parameters": {
"type":"object",
"properties": {
"date": {"type":"string","description":"Дата в формате YYYY-MM-DD"},
"service_id": {"type":"integer","description":"ID услуги"}
},
"required": ["date","service_id"]
}
}
Модель самостоятельно определяет момент вызова и формирует корректные параметры. Ваша задача – точно описать назначение инструмента и типы данных.
Этап 6. Тестирование сценариев и отладка диалогов
Тестирование агента – это не QA в классическом смысле. Нужно проверять не только «happy path», но и граничные случаи: нечёткие запросы, противоречивые данные, попытки вывести агента из роли.
Практические шаги:
Составьте матрицу тест-кейсов: типовые запросы + edge cases (агрессия, нерелевантные темы, пустые сообщения).
Калибруйте температуру модели: устанавливайте 0.0–0.3 для фактических ответов и 0.7–1.0 для творческих задач.
Используйте LangSmith или аналогичный мониторинг для трассировки каждого шага агента во время тестов.
Развертывание, масштабирование и эксплуатация в production
Запустить агента в тестовой среде – половина дела. Реальная эксплуатация (продакшен) требует другого уровня надёжности, наблюдаемости и управления затратами.
Контейнеризация приложения с помощью Docker
Docker обеспечивает идентичность среды: то, что работает локально, будет работать так же на облачном сервере. Контейнер упаковывает код агента, зависимости, переменные окружения и конфигурационные файлы в единый артефакт.
Минимальный Dockerfile для Python-агента включает базовый образ (python:3.12-slim), установку зависимостей изrequirements.txtи команду запуска. После сборки образ деплоится на AWS ECS, Google Cloud Run или любом VPS с Docker Engine.
Настройка систем мониторинга, логирования и алертов
После запуска агента необходим постоянный мониторинг качества работы. Для этого используют специализированные платформы:
LangSmith– трассировка каждого вызова модели, визуализация цепочек, оценка качества ответов.
Langfuse– open-source альтернатива с поддержкой самостоятельного хостинга.
Phoenix (Arize)– глубокая аналитика качества RAG-запросов.
Настройте алерты на аномальный расход токенов (может сигнализировать о зацикливании), ошибки инструментов и время отклика выше порогового значения.
Методы оптимизации производительности и снижения стоимости токенов
Реальная эксплуатация показывает, что стоимость токенов быстро становится значимой статьёй расходов. Практические методы оптимизации:
Кэширование промптов– идентичные системные промпты кэшируются на стороне провайдера (Anthropic и OpenAI поддерживают Prompt Caching).
Выбор модели по задаче– рутинные шаги (классификация, форматирование) выполняет дешёвая модель (GPT-5.5 mini, Claude 4.5 Haiku), сложные рассуждения – старшая.
Оптимизация контекста– не передавайте всю историю диалога целиком; используйте сжатие или суммаризацию старых сообщений.
Сценарии применения и примеры внедрения в бизнес-процессы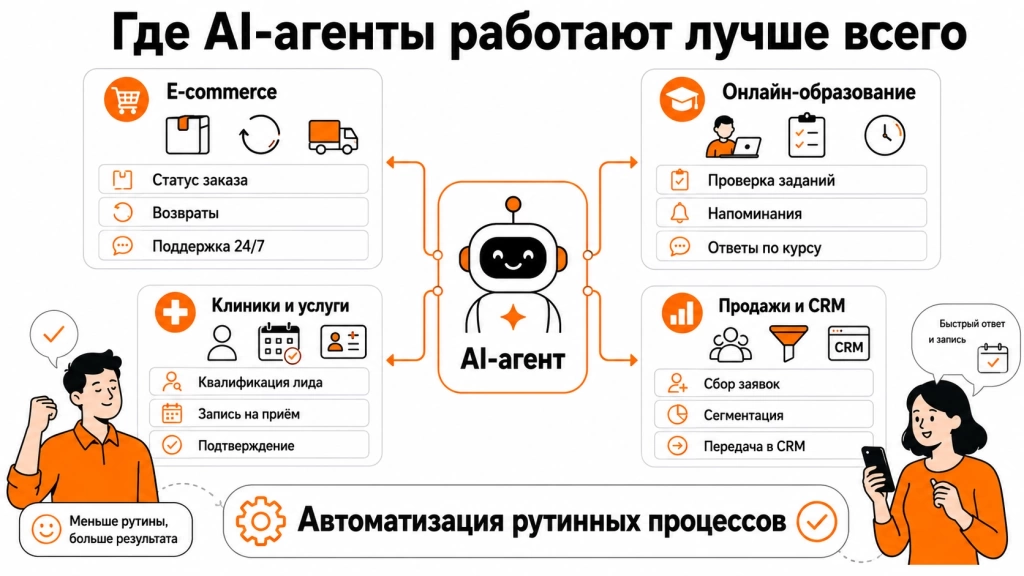
Технологии имеют смысл только в контексте реальных задач. Рассмотрим три отраслевых сценария с конкретной механикой работы.
Автоматизация клиентской поддержки в e-commerce
Агент получает обращение клиента через чат на сайте или в мессенджере. Анализирует тему обращения (рекламация, статус заказа, возврат) и вызывает соответствующий инструмент: запрашивает статус из OMS, инициирует процедуру возврата через API платёжного сервиса или предлагает замену товара на основе истории покупок.
Ключевой результат в e-commerce: снижение нагрузки на операторов первой линии поддержки на 60–70% при одновременном росте удовлетворённости клиентов за счёт мгновенного ответа.
Оптимизация процессов в онлайн-образовании
Виртуальный ассистент студента – один из наиболее эффективных сценариев применения агентов в EdTech. Система проверяет домашние задания по заданным критериям, генерирует персонализированные тесты на основе слабых тем студента (выявленных через историю ошибок), отправляет напоминания о дедлайнах и отвечает на вопросы по учебным материалам через RAG-поиск по курсу.
Интеграция в CRM для медицинских клиник и сферы услуг
ИИ-агент квалифицирует лида прямо в мессенджере: уточняет симптомы или желаемую услугу, проверяет доступные слоты через API Битрикс24 или amoCRM и самостоятельно создаёт запись. Клиент получает подтверждение с деталями, врач – заполненную карточку пациента с предварительным анамнезом.
Важный нюанс для медицины: финальное подтверждение записи должно проходить через Human-in-the-loop – администратор клиники верифицирует запись перед отправкой пациенту.
Безопасность, риски и типичные ошибки при разработке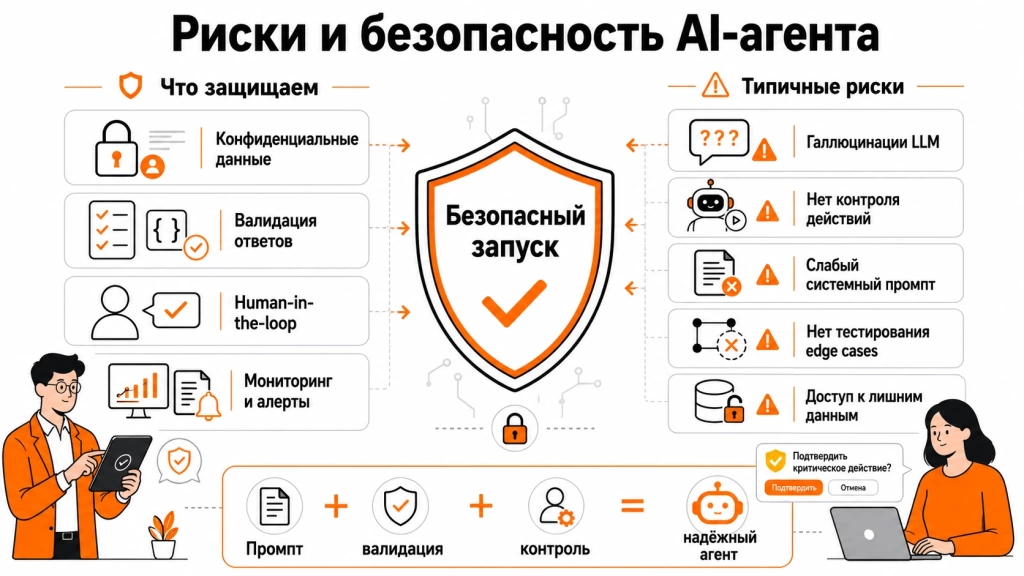
Выход агента в продакшен – это момент, когда технические риски становятся бизнес-рисками. Три критических направления требуют проработки ещё на этапе проектирования.
Защита конфиденциальных данных клиентов
При использовании публичных API (OpenAI, Anthropic) данные пользователей технически проходят через серверы провайдера. Для отраслей с жёсткими правилами безопасности и комплаенса (медицина, финансы, юридические услуги) применяются два подхода:
Анонимизация на входе– перед отправкой в LLM персональные данные заменяются токенами (ФИО → [CLIENT_001], номер карты → [CARD_MASKED]).
On-premise развёртывание– модели Llama 4 или Mistral запускаются на собственных серверах компании, исключая передачу данных третьим лицам.
Проблема галлюцинаций LLM и методы контроля за действиями
Языковые модели склонны генерировать правдоподобно звучащие, но фактически ошибочные ответы. Минимизация галлюцинаций достигается комбинацией методов:
Строгие промпт-ограничения: «Отвечай только на основе предоставленных документов. Если информации нет – сообщи об этом явно».
RAG вместо памяти модели для фактических ответов.
Валидация выходных данных через Pydantic или Guardrails AI – программная проверка формата и содержания ответа перед его отправкой пользователю.
Участие человека в критических точках
Концепция Human-in-the-loop предполагает, что агент готовит действие, но не исполняет его без подтверждения человека. Это обязательный элемент архитектуры для сценариев с финансовыми транзакциями, отправкой официальных документов или предоставлением доступов.
Реализация проста: агент формирует сводку планируемого действия и ожидает явного подтверждения (кнопка в интерфейсе оператора или команда в чат-интерфейсе управления). Только после этого вызывается исполняющий инструмент.
Заключение и чек-лист для успешного запуска
Подводим итоги и фиксируем практический алгоритм для тех, кто готов двигаться вперёд.
Главные выводы по созданию автономных систем
Три принципиальных вывода из всего изложенного:
Архитектура первична– правильный выбор стека и структуры памяти на старте экономит недели переработки в будущем.
Баланс между no-code и кастомным кодомопределяется не амбициями, а реальными требованиями задачи. Не усложняйте без необходимости.
Контроль качества модели– не опциональный этап, а системная часть разработки. Агент без мониторинга и валидации – это риск, а не актив.
Дальнейшие шаги по развитию и масштабированию проекта
После успешного запуска первой версии агента работа не заканчивается – она переходит в фазу итеративного улучшения:
Собирайте аналитику по каждому диалогу: где агент ошибается, какие запросы он не обрабатывает корректно.
Накопив достаточный объём реальных диалогов (обычно 1000+), проводите Fine-tuning модели на своих данных – это даёт ощутимый прирост качества для специфической доменной области.
Постепенно расширяйте пул инструментов и подключайте смежные бизнес-процессы: агент поддержки становится агентом продаж, агент продаж – агентом удержания клиентов.
Создать работающего ИИ-агента – это не финальная точка, а начало системной автоматизации бизнеса.